Tích hợp scikit-clarans vào Pipeline của Scikit-Learn
Ở hai bài viết trước, chúng ta đã thấy K-Medoids giảm ảnh hưởng của ngoại lai bằng cách chọn quan sát thực tế làm tâm cụm (medoid) cùng hàm mục tiêu tổng khoảng cách bậc một, đồng thời điểm qua bốn thuật toán từ PAM, CLARA, CLARANS đến cơ chế đánh giá đồng thời medoid của FastCLARANS nhằm giải bài toán chi phí tính toán trên dữ liệu có độ lớn khác nhau. Tuy nhiên, trong một bài toán học máy thực tế, việc gọi hàm phân cụm đơn lẻ chỉ là mắt xích ở giữa. Một quy trình hoàn chỉnh đòi hỏi khâu tiền xử lý dữ liệu, kiểm soát rò rỉ thông tin (data leakage) khi chia tập kiểm định, tìm số cụm phù hợp và tinh chỉnh các siêu tham số vận hành.
Để người dùng không phải tự viết lại các hàm quản lý vòng đời mô hình, thư viện scikit-clarans được thiết kế tương thích với chuẩn Estimator của Scikit-Learn. Nhờ kế thừa BaseEstimator, ClusterMixin và TransformerMixin, các thuật toán K-Medoids trong thư viện có thể kết hợp trực tiếp với Pipeline, ColumnTransformer, GridSearchCV cũng như đóng vai trò một bộ biến đổi đặc trưng cho các mô hình học có giám sát ở phía sau.
1. Giao diện chuẩn của scikit-clarans trong hệ sinh thái Scikit-Learn
1.1. Cài đặt thư viện
Thư viện được phân phối qua PyPI và cài đặt bằng lệnh:
pip install scikit-clarans
Yêu cầu môi trường gồm Python từ phiên bản 3.9 trở lên cùng các thư viện phụ thuộc numpy, scipy và scikit-learn. Phần lõi tính toán của thuật toán được viết bằng Cython, cung cấp sẵn các gói nhị phân (wheels) cho Linux, macOS và Windows để cài đặt trực tiếp mà không cần trình biên dịch trên máy.
1.2. Các phương thức và thuộc tính cốt lõi
Lớp FastCLARANS cung cấp đầy đủ các phương thức chuẩn của một Scikit-Learn Estimator:
fit(X, y=None): Tìm tập medoid và gán nhãn cho các điểm trong tập dữ liệu huấn luyện . Tham sốyđược giữ lại để tương thích với chữ ký hàm chuẩn của Scikit-Learn (như khi đặt trongPipeline), nhưng không tham gia vào quá trình tính toán.predict(X): Gán các điểm dữ liệu mới về medoid gần nhất đã học được từ phafit.fit_predict(X, y=None): Thực hiện phân cụm và trả về mảng nhãn cụm của tập huấn luyện.transform(X): Tính khoảng cách từ mỗi điểm trong tới medoid, trả về ma trận khoảng cách có kích thước .fit_transform(X, y=None): Vừa tìm medoid vừa trả về ma trận khoảng cách tương ứng.score(X, y=None): Trả về giá trị đối của tổng khoảng cách từ các điểm tới medoid gần nhất (). Phương thức này giúp mô hình tích hợp trực tiếp vào các công cụ tìm kiếm mô hình của Scikit-Learn theo quy ước điểm số càng cao càng tốt.
Về cấu hình khởi tạo, bên cạnh việc bốc mẫu ngẫu nhiên (init='random'), thư viện hỗ trợ chiến lược mặc định init='k-medoids++'. Thuật toán này chọn các medoid khởi đầu với xác suất tỷ lệ với khoảng cách tới các medoid đã chọn trước đó, giúp phân bổ tâm ban đầu đều khắp không gian dữ liệu và giảm số vòng lặp hoán đổi cần thiết. Ngoài ra, thư viện còn hỗ trợ tham số verbose để theo dõi tiến trình tìm kiếm dạng bảng tóm tắt (verbose=1) hoặc chi tiết từng bước hoán đổi (verbose=2).
Sau khi gọi fit(), mô hình lưu lại các thuộc tính kết quả:
cluster_centers_: Mảng hai chiều kích thước chứa tọa độ không gian của medoid. Thuộc tính này nhận giá trịNonenếu sử dụng ma trận khoảng cách tính trước (metric='precomputed').medoid_indices_: Mảng một chiều kích thước lưu chỉ số dòng của các medoid trong tập dữ liệu ban đầu.labels_: Mảng một chiều kích thước chứa nhãn cụm (từ đến ) của từng điểm dữ liệu.inertia_: Tổng khoảng cách bậc một từ mỗi điểm đến medoid gần nhất của nó.n_iter_: Tổng số ứng viên hoán đổi được đánh giá qua tất cả các lượt tìm kiếmnum_local.n_swaps_: Tổng số lần hoán đổi medoid thành công làm giảm chi phí phân cụm.
Đoạn mã dưới đây khởi tạo mô hình và truy xuất các thuộc tính cơ bản trên dữ liệu tổng hợp:
from sklearn.datasets import make_blobs
from clarans import FastCLARANS

X, _ = make_blobs(n_samples=300, centers=4, cluster_std=0.6, random_state=42)

model = FastCLARANS(n_clusters=4, num_local=2, random_state=42)
model.fit(X)

print(f"Chiến lược khởi tạo: {model.init}")
print(f"Chỉ số medoid: {model.medoid_indices_}")
print(f"Inertia (tổng khoảng cách L1): {model.inertia_:.2f}")
print(f"Điểm score(X): {model.score(X):.2f}")
print(f"Số lần hoán đổi thành công: {model.n_swaps_}")
print(f"Kích thước tọa độ tâm medoid: {model.cluster_centers_.shape}")
Kết quả in ra từ thực nghiệm:
Chiến lược khởi tạo: k-medoids++
Chỉ số medoid: [121 180 201 237]
Inertia (tổng khoảng cách L1): 219.78
Điểm score(X): -219.78
Số lần hoán đổi thành công: 6
Kích thước tọa độ tâm medoid: (4, 2)
2. Xây dựng Pipeline và chiến lược chuẩn hóa cho K-Medoids
Các thuật toán thuộc họ K-Medoids phân nhóm dữ liệu dựa trên khoảng cách giữa các điểm quan sát. Khi các thuộc tính có đơn vị đo khác nhau, chẳng hạn thu nhập hàng chục triệu đồng và số năm công tác từ 1 đến 20, thuộc tính có biên độ số học lớn sẽ chi phối kết quả tính khoảng cách. Vì vậy, dữ liệu cần được chuẩn hóa thang đo trước khi đưa vào mô hình.
2.1. Vì sao K-Medoids cần RobustScaler thay vì StandardScaler?
Trong Scikit-Learn, hai bộ chuẩn hóa thường gặp là StandardScaler và RobustScaler:
StandardScalerchuẩn hóa dữ liệu dựa trên giá trị trung bình và độ lệch chuẩn :
Cả hai đại lượng này đều nhạy cảm với các giá trị ngoại lai. Khi tập dữ liệu có nhiễu cực đoan, điểm trung bình và độ lệch chuẩn bị kéo lệch, dẫn đến việc thu hẹp khoảng cách giữa các điểm dữ liệu thông thường.
RobustScalergiảm ảnh hưởng của ngoại lai bằng cách dùng trung vị (median) làm tâm và khoảng tứ phân vị (Interquartile Range, ) làm thang đo tỉ lệ:
Do trung vị và khoảng tứ phân vị chỉ tính toán dựa trên các phân vị ở giữa (từ 25% đến 75%), các giá trị ngoại lai cực đoan ở hai đuôi phân phối không làm lệch thang đo của phần lớn dữ liệu còn lại. Vì K-Medoids thường được chọn cho các bài toán cần hạn chế ảnh hưởng của ngoại lai, RobustScaler là bộ biến đổi phù hợp để đi cùng CLARANS/FastCLARANS.
2.2. Đóng gói quy trình và tra cứu medoid gốc
Đóng gói các bước vào Pipeline giúp cô lập việc tính toán tham số chuẩn hóa trong từng tập mẫu, ngăn ngừa rủi ro rò rỉ dữ liệu khi đánh giá chéo.
import numpy as np
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import RobustScaler
from clarans import FastCLARANS

# Giả lập dữ liệu có ngoại lai ở xa
np.random.seed(42)
X_normal = np.random.randn(200, 2)
X_outliers = np.random.uniform(low=20, high=30, size=(10, 2))
X_data = np.vstack([X_normal, X_outliers])

pipeline = Pipeline([
    ('scaler', RobustScaler()),
    ('clustering', FastCLARANS(n_clusters=3, random_state=42))
])
pipeline.fit(X_data)

# Trích xuất medoid trên không gian gốc chưa qua chuẩn hóa
medoid_idx = pipeline.named_steps['clustering'].medoid_indices_
raw_medoids = X_data[medoid_idx]

print("Chỉ số medoid trên dữ liệu gốc:", medoid_idx)
print("Tọa độ medoid gốc:\n", np.round(raw_medoids, 4))
Kết quả in ra từ thực nghiệm:
Chỉ số medoid trên dữ liệu gốc: [ 92 166 209]
Tọa độ medoid gốc:
 [[-0.2235  0.714 ]
 [ 0.0758 -0.6772]
 [26.1813 23.5816]]
Trong đoạn mã trên, clustering_pipeline.named_steps['clustering'].cluster_centers_ lưu tọa độ của medoid trên không gian đã qua RobustScaler. Nếu cần lấy tọa độ ban đầu của medoid, ta dùng trực tiếp mảng medoid_indices_ để trích xuất dòng tương ứng từ tập dữ liệu gốc X_data, hoặc gọi phương thức clustering_pipeline.named_steps['scaler'].inverse_transform(model.cluster_centers_). Cách làm này giữ nguyên khả năng diễn giải trên mẫu quan sát thực tế sau khi đã chuẩn hóa dữ liệu.
3. Xác định số cụm k bằng Inertia và Silhouette Score
Trong học không giám sát, số cụm hiếm khi được xác định trước. Hai tiêu chí phổ biến để ước lượng gồm phương pháp Elbow dựa trên inertia_ và hệ số Silhouette.
3.1. Cơ sở toán học của hai chỉ số đánh giá
Khác với K-Means dùng tổng bình phương khoảng cách Euclid (chuẩn L2 bậc hai), thuộc tính inertia_ trong scikit-clarans biểu thị tổng khoảng cách bậc một từ mỗi điểm đến medoid gần nhất:
Khi tăng giá trị , khoảng cách từ mỗi điểm đến medoid gần nhất luôn giảm dần. Đường biểu diễn của Inertia theo thường có dạng giảm dốc rồi thoải dần. Vị trí gập khúc (elbow point) thể hiện ngưỡng mà việc bổ sung thêm cụm không còn làm giảm đáng kể khoảng cách nội cụm.
Bên cạnh đó, hệ số Silhouette đo lường mức độ tương đồng của một điểm với cụm của nó so với cụm láng giềng gần nhất. Với mẫu , gọi là khoảng cách trung bình đến các điểm khác trong cùng cụm, và là khoảng cách trung bình nhỏ nhất đến các điểm thuộc một cụm khác:
Điểm Silhouette trung bình trên toàn tập mẫu nhận giá trị trong đoạn . Giá trị càng gần cho thấy các cụm được phân tách rõ ràng và có mật độ đồng nhất.
3.2. Quét tìm k tối ưu trên dữ liệu thực nghiệm
Đoạn mã sau quét qua các giá trị từ 2 đến 7, ghi nhận inertia_ và silhouette_score tương ứng:
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import RobustScaler
from sklearn.metrics import silhouette_score
from clarans import FastCLARANS

X_blobs, _ = make_blobs(n_samples=500, centers=4, cluster_std=0.7, random_state=42)

k_values = list(range(2, 8))
inertias = []
silhouette_scores = []

for k in k_values:
    pipe = Pipeline([
        ('scaler', RobustScaler()),
        ('clustering', FastCLARANS(n_clusters=k, random_state=42))
    ])
    pipe.fit(X_blobs)

    X_scaled = pipe.named_steps['scaler'].transform(X_blobs)
    clustering = pipe.named_steps['clustering']

    inertias.append(clustering.inertia_)
    silhouette_scores.append(silhouette_score(X_scaled, clustering.labels_))

# Trực quan hóa phương pháp Elbow và hệ số Silhouette
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(11, 4.2))

ax1.plot(k_values, inertias, marker='o', color='#2b5c8f', linewidth=2)
ax1.set_xlabel('Số lượng cụm (k)')
ax1.set_ylabel('Inertia (Tổng khoảng cách L1)')
ax1.set_title('(a) Phương pháp Elbow với Inertia')
ax1.axvline(x=4, color='#e41a1c', linestyle=':', label='Điểm uốn k=4')
ax1.grid(True, linestyle='--', alpha=0.5)
ax1.legend()

ax2.plot(k_values, silhouette_scores, marker='s', color='#d95f02', linewidth=2)
ax2.set_xlabel('Số lượng cụm (k)')
ax2.set_ylabel('Silhouette Score trung bình')
ax2.set_title('(b) Đánh giá qua hệ số Silhouette')
ax2.axvline(x=4, color='#e41a1c', linestyle=':', label='Đỉnh tối ưu k=4')
ax2.grid(True, linestyle='--', alpha=0.5)
ax2.legend()

plt.tight_layout()
plt.show()
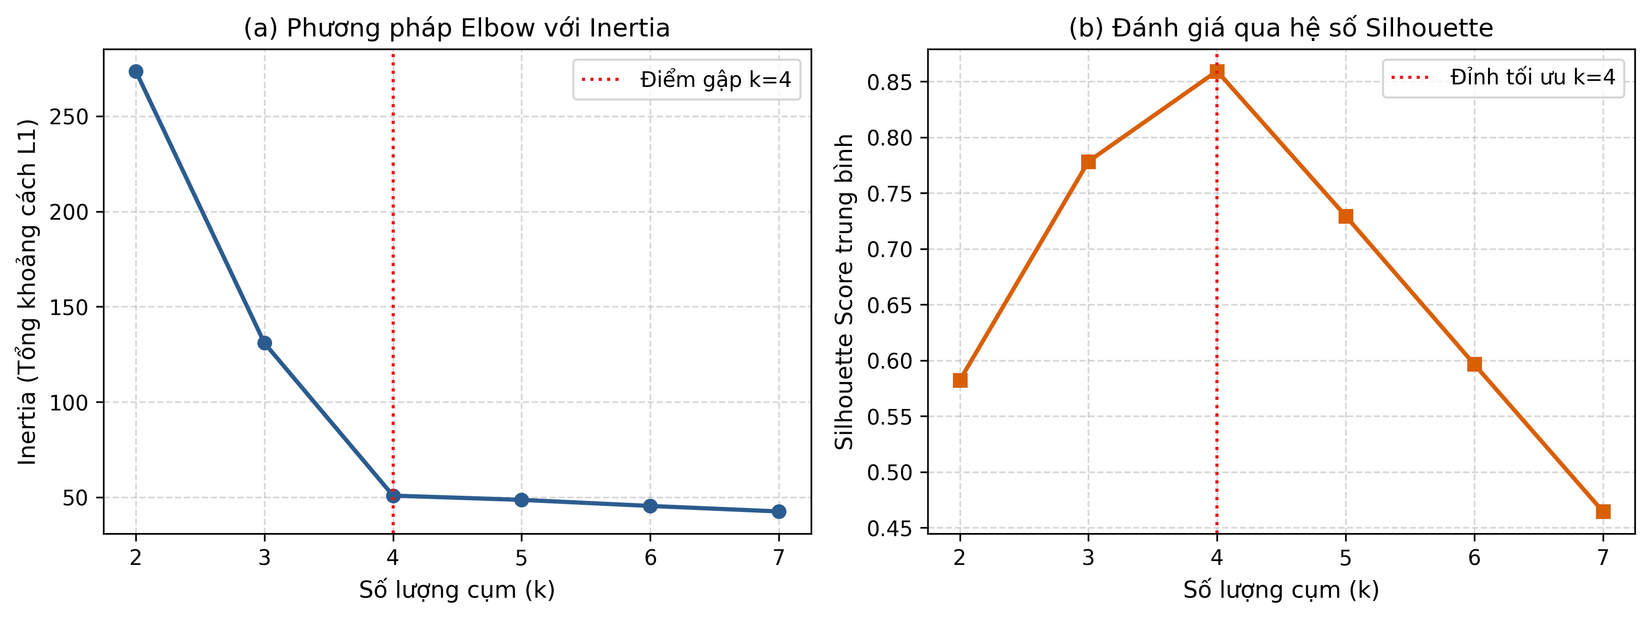
Bảng kết quả định lượng thu được từ lần chạy:
k=2: Inertia = 273.61, Silhouette = 0.5821
k=3: Inertia = 130.92, Silhouette = 0.7783
k=4: Inertia = 50.84,  Silhouette = 0.8594
k=5: Inertia = 48.61,  Silhouette = 0.7295
k=6: Inertia = 45.41,  Silhouette = 0.5965
k=7: Inertia = 42.54,  Silhouette = 0.4646
Từ đến , giá trị Inertia giảm mạnh từ 273.61 xuống 50.84. Khi tiếp tục tăng lên , mức giảm chậm lại rõ rệt (chỉ giảm thêm 2.23 đơn vị xuống 48.61), tạo thành điểm uốn Elbow tại . Cùng lúc đó, hệ số Silhouette đạt đỉnh ở mức 0.8594 tại rồi giảm dần ở các mốc tiếp theo. Cả hai chỉ số cùng xác nhận là cấu hình phù hợp với cấu trúc phân bố của tập dữ liệu.
4. Tinh chỉnh siêu tham số với GridSearchCV qua Custom Scorer
GridSearchCV trong Scikit-Learn được thiết kế ban đầu cho bài toán học có giám sát, nơi nhãn mục tiêu y luôn có sẵn để đối chiếu. Mặc dù FastCLARANS đã tích hợp sẵn phương thức score() trả về , tổng khoảng cách này luôn giảm dần khi số cụm tăng lên. Nếu dùng trực tiếp score() mặc định để tìm tối ưu, GridSearchCV sẽ luôn ưu tiên chọn giá trị lớn nhất trong dải tham số. Vì vậy, để đánh giá chất lượng phân cụm một cách khách quan khi thay đổi, việc xây dựng hàm chấm điểm tùy chỉnh (custom scorer) qua hệ số Silhouette (tương tự như kịch bản plot_pipeline_gridsearch.py trong tài liệu thư viện) là giải pháp phù hợp.
4.1. Thiết lập hàm chấm điểm cho dữ liệu không nhãn
Trong mỗi vòng lặp kiểm định chéo của GridSearchCV, mô hình được huấn luyện trên tập mẫu con X_train và chuyển sang bước đánh giá trên tập kiểm định X_val. Hàm chấm điểm nhận đầu vào gồm đối tượng estimator và ma trận X_val.
Để tính toán chính xác, hàm scorer cần thực hiện các thao tác:
- Đưa
X_valqua bước chuẩn hóa của pipeline để có không gian dữ liệu đồng nhất. - Dự đoán nhãn cụm cho
X_valthông qua phương thứcestimator.predict(X_val). - Kiểm tra số lượng nhãn cụm được gán trên
X_val. Nếu số cụm hợp lệ nhỏ hơn 2 (toàn bộ điểm bị gán vào cùng một cụm) hoặc lớn hơn hay bằng số mẫu, hàm trả về điểm số phạt . - Tính toán và trả về giá trị
silhouette_scoretrên tậpX_val.
from sklearn.metrics import silhouette_score
from sklearn.model_selection import KFold, GridSearchCV
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import RobustScaler
from clarans import FastCLARANS

def cluster_silhouette_scorer(estimator, X, y=None):
    # Lấy dữ liệu đã chuẩn hóa nếu mô hình nằm trong Pipeline
    if hasattr(estimator, 'named_steps') and 'scaler' in estimator.named_steps:
        X_trans = estimator.named_steps['scaler'].transform(X)
        metric = estimator.named_steps['clustering'].metric
    else:
        X_trans = X
        metric = getattr(estimator, 'metric', 'euclidean')

    labels = estimator.predict(X)
    if len(set(labels)) < 2:
        return -1.0

    return silhouette_score(X_trans, labels, metric=metric)
4.2. Thực thi kiểm định chéo và lựa chọn tham số
Các tham số cần khảo sát của FastCLARANS gồm:
clustering__n_clusters: Số cụm cần chia.clustering__metric: Độ đo khoảng cách ('euclidean'hoặc'manhattan').clustering__init: Chiến lược khởi tạo medoid ('k-medoids++'hoặc'random').clustering__num_local: Số lần khởi tạo tìm kiếm cục bộ độc lập từ các đỉnh ngẫu nhiên khác nhau để hạn chế rơi vào cực tiểu cục bộ.
Vì bài toán không có nhãn để chia theo tầng (StratifiedKFold), ta dùng KFold có xáo trộn ngẫu nhiên:
pipeline = Pipeline([
    ('scaler', RobustScaler()),
    ('clustering', FastCLARANS(random_state=42))
])

param_grid = {
    'clustering__n_clusters': [3, 4, 5],
    'clustering__metric': ['euclidean', 'manhattan'],
    'clustering__init': ['k-medoids++', 'random'],
    'clustering__num_local': [2, 4]
}

cv = KFold(n_splits=3, shuffle=True, random_state=42)

grid = GridSearchCV(
    estimator=pipeline,
    param_grid=param_grid,
    scoring=cluster_silhouette_scorer,
    cv=cv,
    n_jobs=1
)
grid.fit(X_blobs)

print("Tổ hợp tham số tốt nhất:")
for param, val in grid.best_params_.items():
    print(f"  {param}: {val}")

print(f"Silhouette Score trung bình trên tập kiểm định: {grid.best_score_:.4f}")
Kết quả in ra từ thực nghiệm:
Tổ hợp tham số tốt nhất:
  clustering__init: k-medoids++
  clustering__metric: euclidean
  clustering__n_clusters: 4
  clustering__num_local: 2
Silhouette Score trung bình trên tập kiểm định: 0.8540
Kết quả kiểm định chéo ghi nhận cấu hình gồm khởi tạo k-medoids++, khoảng cách Euclid, và num_local = 2 đạt điểm Silhouette trung bình 0.8540 trên các tập dữ liệu con được giữ lại. Việc chiến lược k-medoids++ được chọn thay vì khởi tạo ngẫu nhiên phản ánh đúng ưu điểm của việc chọn tâm phân tán đều ngay từ đầu, đồng thời cho thấy mô hình duy trì chất lượng phân cụm ổn định khi gặp dữ liệu mới.
5. Dùng khoảng cách Medoid làm đặc trưng biến đổi với transform()
Ngoài khả năng gán nhãn, FastCLARANS còn kế thừa lớp TransformerMixin của Scikit-Learn. Phương thức transform(X) chuyển đổi ma trận dữ liệu ban đầu thành một không gian đặc trưng mới dựa trên khoảng cách.
5.1. Cơ chế ánh xạ không gian khoảng cách
Khi gọi transform(X) trên mô hình đã có medoid, đầu ra là ma trận có kích thước . Giá trị tại dòng , cột biểu diễn khoảng cách từ quan sát đến medoid :
Trong K-Means, phép transform() tính khoảng cách tới các centroid, vốn là tọa độ trung bình số học do thuật toán tổng hợp. Trong K-Medoids, mỗi chiều trong không gian đặc trưng mới biểu thị khoảng cách tới một quan sát thực tế trong tập dữ liệu. Nhờ đó, các giá trị sau biến đổi có thể giải thích trực tiếp theo ngữ cảnh nghiệp vụ, chẳng hạn mức độ tương đồng giữa một khách hàng mới với từng hồ sơ khách hàng mẫu đại diện.
Do tuân thủ đầy đủ chuẩn TransformerMixin, FastCLARANS cung cấp thêm phương thức get_feature_names_out(), tự động gán nhãn cho các cột đặc trưng mới theo dạng ['fastclarans0', 'fastclarans1', ...]. Khi kết hợp với cấu hình pipeline.set_output(transform='pandas'), đầu ra của bước transform() sẽ là một DataFrame hoàn chỉnh với tên cột rõ ràng, giúp việc kết hợp với ColumnTransformer hoặc đưa vào các mô hình học máy phía sau trở nên thuận tiện.
5.2. Ứng dụng phân loại trên tập dữ liệu phi tuyến
Ánh xạ dữ liệu sang không gian khoảng cách tới các medoid tạo ra một phép biến đổi đặc trưng phi tuyến (non-linear feature mapping). Phép biến đổi này giúp các bộ phân loại tuyến tính đơn giản giải quyết được các tập dữ liệu có ranh giới phân tách phức tạp mà không cần dùng đến các hàm nhân (kernel) tốn bộ nhớ.
Trong bài toán phân loại hai nửa vầng trăng (make_moons), tập dữ liệu chỉ có hai lớp nhãn (lớp 0 và lớp 1). Một câu hỏi đặt ra từ thực tế: bước transform() cần bao nhiêu medoid ? Để có căn cứ lựa chọn, ta tiến hành khảo sát thực nghiệm giá trị từ đến , so sánh độ chính xác trên tập kiểm tra với mô hình cơ sở (LogisticRegression chạy trực tiếp trên 2 đặc trưng gốc) và kiểm tra phân bố nhãn thực tế của các medoid được chọn.
import numpy as np
from sklearn.datasets import make_moons
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import RobustScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
from clarans import FastCLARANS

X_m, y_m = make_moons(n_samples=600, noise=0.2, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X_m, y_m, test_size=0.3, random_state=42)

# Mô hình cơ sở trên 2 đặc trưng gốc
base_pipe = Pipeline([
    ('scaler', RobustScaler()),
    ('clf', LogisticRegression(random_state=42))
])
base_pipe.fit(X_train, y_train)
acc_base = accuracy_score(y_test, base_pipe.predict(X_test))
print(f"Độ chính xác mô hình cơ sở (2 đặc trưng gốc): {acc_base * 100:.2f}%\n")

# Khảo sát giá trị k từ 2 đến 14
for k in [2, 3, 4, 5, 6, 8, 10, 12, 14]:
    pipe = Pipeline([
        ('scaler', RobustScaler()),
        ('medoid_features', FastCLARANS(n_clusters=k, random_state=42)),
        ('clf', LogisticRegression(random_state=42))
    ])
    pipe.fit(X_train, y_train)
    acc = accuracy_score(y_test, pipe.predict(X_test))

    med_idx = pipe.named_steps['medoid_features'].medoid_indices_
    med_labels = y_train[med_idx]
    c0 = (med_labels == 0).sum()
    c1 = (med_labels == 1).sum()
    print(f"k = {k:2d}: Accuracy = {acc * 100:.2f}% | Phân bổ: {c0} medoid lớp 0 / {c1} medoid lớp 1")
Kết quả in ra từ thực nghiệm:
Độ chính xác mô hình cơ sở (2 đặc trưng gốc): 87.22%

k =  2: Accuracy = 84.44% | Phân bổ: 2 medoid lớp 0 / 0 medoid lớp 1
k =  3: Accuracy = 86.67% | Phân bổ: 1 medoid lớp 0 / 2 medoid lớp 1
k =  4: Accuracy = 88.33% | Phân bổ: 2 medoid lớp 0 / 2 medoid lớp 1
k =  5: Accuracy = 88.33% | Phân bổ: 3 medoid lớp 0 / 2 medoid lớp 1
k =  6: Accuracy = 91.11% | Phân bổ: 3 medoid lớp 0 / 3 medoid lớp 1
k =  8: Accuracy = 91.11% | Phân bổ: 4 medoid lớp 0 / 4 medoid lớp 1
k = 10: Accuracy = 91.11% | Phân bổ: 6 medoid lớp 0 / 4 medoid lớp 1
k = 12: Accuracy = 92.22% | Phân bổ: 8 medoid lớp 0 / 4 medoid lớp 1
k = 14: Accuracy = 92.22% | Phân bổ: 7 medoid lớp 0 / 7 medoid lớp 1
Số liệu đo đạc từ lần chia mẫu ngẫu nhiên đầu tiên cho thấy:
- Khi : Do phân cụm hoàn toàn không giám sát, thuật toán chọn phải 2 medoid đều thuộc về lớp 0. Việc thiếu điểm mốc đại diện cho lớp 1 khiến mô hình phân loại bị lệch, độ chính xác tụt xuống , kém hơn cả mô hình chạy trực tiếp trên 2 tọa độ gốc ().
- Khi và : Cả hai cấu hình đều đạt độ chính xác trên lần chia mẫu này và đều có tỷ lệ medoid cân bằng ( và ).
Để phân định khách quan xem cấu hình nào mang lại tính tổng quát hóa cao hơn thay vì phụ thuộc vào một lần chia dữ liệu ngẫu nhiên, ta thực hiện kiểm định chéo 5-fold (5-fold Cross-Validation) trên toàn bộ 600 mẫu dữ liệu, theo dõi đồng thời độ chính xác (Accuracy), diện tích dưới đường cong ROC (ROC-AUC) và hàm mất mát Log-loss:
from sklearn.model_selection import StratifiedKFold
from sklearn.metrics import log_loss, roc_auc_score

# Kiểm định chéo 5-fold so sánh k=6 và k=8 trên toàn bộ 600 mẫu
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

for k_val in [6, 8]:
    cv_accs, cv_rocs, cv_losses = [], [], []
    for tr_idx, te_idx in cv.split(X_m, y_m):
        pipe = Pipeline([
            ('scaler', RobustScaler()),
            ('medoid_features', FastCLARANS(n_clusters=k_val, random_state=42)),
            ('clf', LogisticRegression(random_state=42))
        ])
        pipe.fit(X_m[tr_idx], y_m[tr_idx])
        y_prob = pipe.predict_proba(X_m[te_idx])
        cv_accs.append(pipe.score(X_m[te_idx], y_m[te_idx]))
        cv_rocs.append(roc_auc_score(y_m[te_idx], y_prob[:, 1]))
        cv_losses.append(log_loss(y_m[te_idx], y_prob))

    print(f"k = {k_val}: Mean Accuracy = {np.mean(cv_accs)*100:.2f}% (+/- {np.std(cv_accs)*100:.2f}%) | "
          f"ROC-AUC = {np.mean(cv_rocs):.4f} | Log-loss = {np.mean(cv_losses):.4f}")
Kết quả in ra từ thực nghiệm kiểm định chéo:
k = 6: Mean Accuracy = 90.00% (+/- 3.03%) | ROC-AUC = 0.9549 | Log-loss = 0.2747
k = 8: Mean Accuracy = 91.50% (+/- 2.95%) | ROC-AUC = 0.9674 | Log-loss = 0.2389
Khi đối chiếu kiểm định chéo giữa hai cấu hình:
- Về độ chính xác: đạt mức trung bình , nhỉnh hơn so với mức của , đồng thời có độ lệch chuẩn nhỏ hơn.
- Về ước lượng xác suất: ROC-AUC tăng từ lên , và Log-loss giảm từ xuống (giảm hơn ). Việc bố trí 4 medoid trên mỗi vòng cung (thay vì 3) giúp mô hình ước lượng xác suất phân lớp dứt khoát hơn ở các khúc uốn cong hẹp, giảm bớt các dự đoán lấp lửng tại vùng ranh giới.
Nhờ hiệu năng ổn định hơn trên các tập fold và sai số mất mát thấp hơn, được dùng làm cấu hình đại diện để trực quan hóa trong bước tiếp theo.
Đoạn mã sau huấn luyện mô hình với , in kết quả đánh giá trên tập kiểm tra và vẽ đồ thị so sánh ranh giới quyết định:
# Huấn luyện pipeline với k=8
medoid_pipe = Pipeline([
    ('scaler', RobustScaler()),
    ('medoid_features', FastCLARANS(n_clusters=8, random_state=42)),
    ('clf', LogisticRegression(random_state=42))
])
medoid_pipe.fit(X_train, y_train)

acc_medoid = accuracy_score(y_test, medoid_pipe.predict(X_test))
print(f"Độ chính xác mô hình với k=8 medoid: {acc_medoid * 100:.2f}%")

# Vẽ đồ thị so sánh ranh giới quyết định
h = 0.03
x_min, x_max = X_m[:, 0].min() - 0.5, X_m[:, 0].max() + 0.5
y_min, y_max = X_m[:, 1].min() - 0.5, X_m[:, 1].max() + 0.5
xx, yy = np.meshgrid(np.arange(x_min, x_max, h), np.arange(y_min, y_max, h))
grid = np.c_[xx.ravel(), yy.ravel()]

Z_linear = base_pipe.predict(grid).reshape(xx.shape)
Z_medoid = medoid_pipe.predict(grid).reshape(xx.shape)

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 4.8))

# Đồ thị (a): Tuyến tính gốc
ax1.contourf(xx, yy, Z_linear, alpha=0.25, cmap=plt.cm.coolwarm)
ax1.scatter(X_test[y_test == 0, 0], X_test[y_test == 0, 1], color='#2b5c8f', label='Lớp 0', edgecolors='k', alpha=0.7)
ax1.scatter(X_test[y_test == 1, 0], X_test[y_test == 1, 1], color='#d95f02', label='Lớp 1', edgecolors='k', alpha=0.7)
ax1.set_title(f'(a) Đặc trưng gốc + Logistic Regression\nĐộ chính xác: {acc_base * 100:.1f}%')
ax1.set_xlabel('Đặc trưng X1')
ax1.set_ylabel('Đặc trưng X2')
ax1.legend(loc='lower left')
ax1.grid(True, linestyle='--', alpha=0.3)

# Đồ thị (b): Biến đổi khoảng cách tới 8 Medoid
ax2.contourf(xx, yy, Z_medoid, alpha=0.25, cmap=plt.cm.coolwarm)
ax2.scatter(X_test[y_test == 0, 0], X_test[y_test == 0, 1], color='#2b5c8f', label='Lớp 0', edgecolors='k', alpha=0.7)
ax2.scatter(X_test[y_test == 1, 0], X_test[y_test == 1, 1], color='#d95f02', label='Lớp 1', edgecolors='k', alpha=0.7)

# Vẽ tọa độ gốc của 8 medoid đại diện
scaler = medoid_pipe.named_steps['scaler']
clustering = medoid_pipe.named_steps['medoid_features']
medoids_orig = scaler.inverse_transform(clustering.cluster_centers_)
ax2.scatter(medoids_orig[:, 0], medoids_orig[:, 1], c='#ffd700', marker='*', s=300, edgecolors='black', linewidth=1.8, label='8 Medoids đại diện', zorder=10)

ax2.set_title(f'(b) Khoảng cách tới 8 Medoid + Logistic Regression\nĐộ chính xác: {acc_medoid * 100:.1f}%')
ax2.set_xlabel('Đặc trưng X1')
ax2.set_ylabel('Đặc trưng X2')
ax2.legend(loc='lower left')
ax2.grid(True, linestyle='--', alpha=0.3)

plt.tight_layout()
plt.show()
Kết quả in ra từ thực nghiệm:
Độ chính xác mô hình với k=8 medoid: 91.11%
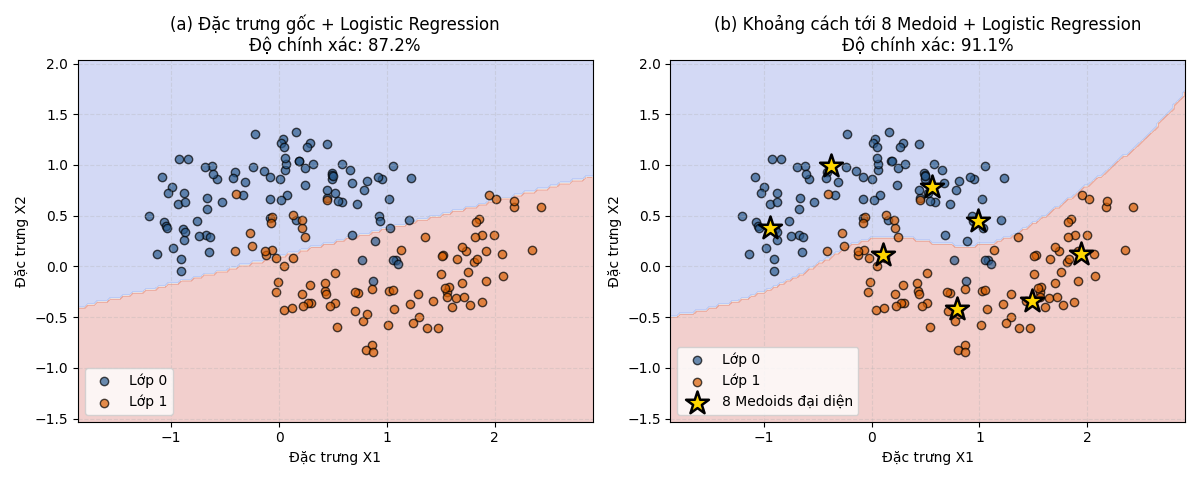
Trên đồ thị (a), mô hình LogisticRegression huấn luyện trên không gian 2 chiều ban đầu chỉ tạo được một đường ranh giới thẳng, chia cắt phần thân của hai vòng cung và đạt độ chính xác 87.2%. Trên đồ thị (b), khi dữ liệu được chuyển đổi sang 8 chiều khoảng cách tới 8 medoid thực tế (ký hiệu bằng các ngôi sao vàng), ranh giới quyết định của bộ phân loại uốn cong theo hình dạng của hai cụm, nâng độ chính xác trên tập kiểm tra lên 91.1%.
6. Tổng kết quy trình tích hợp và lưu ý thực tế
| Bước trong quy trình | Công cụ sử dụng | Mục đích kỹ thuật |
|---|---|---|
| Tiền xử lý | RobustScaler |
Chuẩn hóa thang đo theo median và IQR, giữ cấu trúc khoảng cách khi có ngoại lai |
| Đóng gói mô hình | Pipeline |
Ghép nối khép kín từ bước co giãn dữ liệu đến phân cụm, ngăn rò rỉ dữ liệu khi kiểm định |
| Đánh giá số cụm | silhouette_score, inertia_ |
Đối chiếu độ gắn kết nội cụm và mức độ phân tách giữa các cụm |
| Tinh chỉnh tham số | GridSearchCV + custom_scorer |
Đánh giá khả năng tổng quát hóa của các tổ hợp tham số trên các tập kiểm định con |
| Trích xuất đặc trưng | FastCLARANS.transform() |
Tạo biểu diễn khoảng cách tới các mẫu thực tế cho các mô hình phân loại phía sau |
Toàn bộ đối tượng Pipeline sau khi huấn luyện có thể lưu trữ vào tệp bằng joblib.dump(clustering_pipeline, 'kmedoids_pipeline.joblib') để sử dụng trực tiếp trong các ứng dụng thực tế mà không cần cấu hình rời bước tiền xử lý bên ngoài.
Trong bài viết tiếp theo, chúng ta sẽ áp dụng quy trình này vào bài toán phân khúc khách hàng trên tập dữ liệu hỗn hợp (chứa đồng thời biến số liên tục và biến phân loại), thử nghiệm các độ đo phi Euclid như khoảng cách Manhattan, Cosine và trích xuất hồ sơ khách hàng đại diện từ chính các medoid tìm được.
All rights reserved